本帖最后由 疯狼GC 于 2026-10-29 08:17 编辑
大家好,我是嘟嘟,深耕ComfyUI赛道的程序员。 9 月 8 日开源的 IndexTTS2 成语音克隆王炸!支持单人 / 多人克隆,3 种情感方案(提示词 / 音频 / 向量),ComfyUI 插件已更,附教程破解安装难题。这个插件很难装,各位做好心理装备! 一、IndexTTS2介绍
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程

哇,今天这个厉害了, 语音克隆的王炸IndexTTS2终于在9月8号开源了,效果好是真的好,但是难装也是真的难。 IndexTTS2支持单人多人声音克隆,并且支持情感,三种方案支持情感处理,分别是:提示词、情感音频参考、情绪控制向量。 技术架构:
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程

官方案例: 二、相关安装ComfyUI插件地址:https://github.com/billwuhao/ComfyUI_IndexTTS 安装这个我之前各种报错,大家要尝试做好心理准备,看看问题列表别人的反馈。
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程

我安装正常修改如下几个部分,大家当做参考吧: transformers版本 4.51.3 轮子安装: 插件requirements.txt注释掉如下几行:
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程

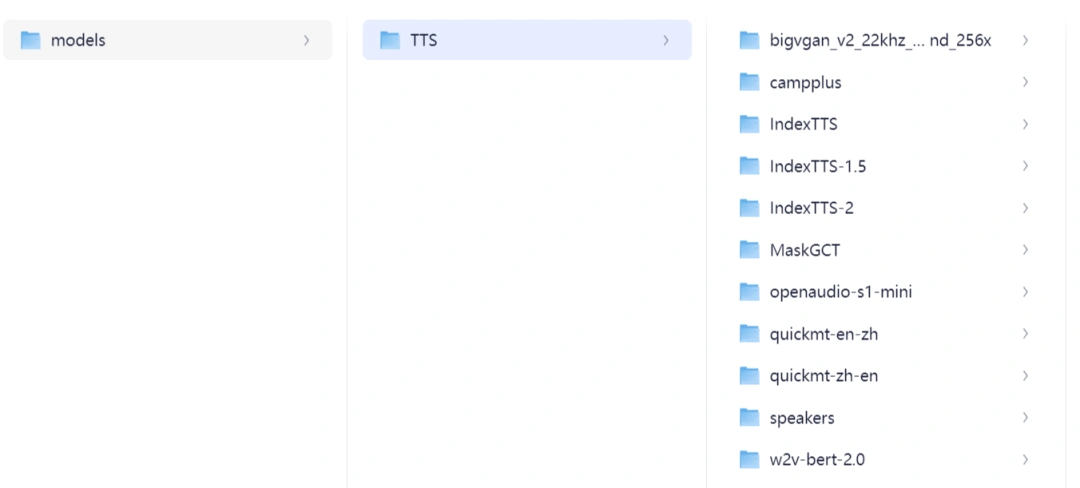
对了,本地环境推荐大家更新到torch2.7+cuda12.8,因为现在很多轮子是对这个支持比较好,上面deepspeed轮子最低要求也是这个。 我一开始一直开在pynini编译报错,我自己的轮子安装也不行,后来别人提示说注释掉原来requirements.txt的那几行才行,这样就会用我自己编译好的,而不是重新去编译。 用到的模型我已经放到网盘了, 文末获取。 模型存放路径:ComfyUImodelsTTS
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
三、测评体验终于来到大家激动的测试环节了,本地实在安装不了的先去RunningHub上体验,这次玩法一共分成两块 3.1 单人克隆
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
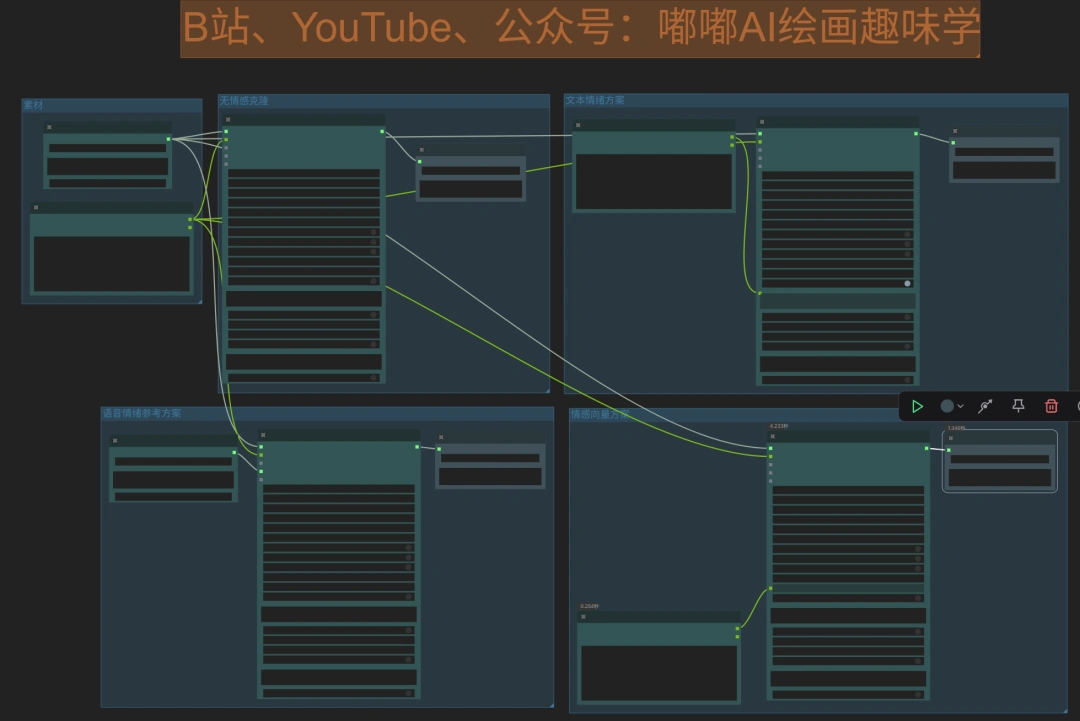
单人方面给大家弄了4种方式,分别是不带情况,文本情感方案、语音情绪参考方案、情感向量方案。 在开始前,先把一些重要参考列出来 V2重要参数说明(全是可选的):
deepspeed: 是否开启 deepspeed 加速(需要先安装deepspeed)。
emo_audio_prompt: 第一个说话人,情绪音频参考。
emo_alpha: 第一个说话人,情绪强度。
emo_vector: 第一个说话人,情绪控制向量,英文格式输入类似这样的列表 [0, 0, 0, 0, 0, 0, 0.45, 0](每一个强度范围0-1,表示惊喜强度 0.45),数字分别对应 : [Happy, Angery, Sad, Fear, Hate, Low, Surprise, Neutral], 几乎无限组合。
use_emo_text: 第一个说话人,是否开启提示词控制情绪。如果使用提示词控制,情绪参考音频失效。
emo_text: 第一个说话人,情绪控制提示词。随便写,例如 哭哭。。。苦苦。。。
use_random: 第一个说话人,是否开启随机性。
emo_audio_prompt_s2: 第二个说话人,同上。
emo_alpha_s2: 第二个说话人,同上。
emo_vector_s2: 第二个说话人,同上。
use_emo_text_s2: 第二个说话人,同上。
emo_text_s2: 第二个说话人,同上。
use_random_s2: 第二个说话人,同上。
如果不提供任何情绪控制,自动使用克隆音频作为情绪参考。
重要参数说明(其他参数不是很重要的就不一一介绍了):
max_mel_tokens: 控制生成的语音长度, 长文本需要增加这个参数.
max_text_tokens_per_sentence: 分句的最大token数,越小,推理速度越快,占用内存更多,可能影响质量
sentences_bucket_max_size: 分句分桶的最大容量,越大,推理速度越快,占用内存更多,可能影响质量
fast_inference: 开启快速推理
custom_cuda_kernel: 开启自定义 CUDA 内核, 第一次运行将自动构建 CUDA 内核扩展
dialogue_audio_s2: 双人会话时的第二个音频, 如果输入这个音频, 自动启动会话模式. 会话模式下, 输入文本必须如下([S1] 表示第一个说话者, [S2] 表示第二个说话者):
[S1] 轻喘像风掠过耳畔,
[S2] 你靠近时,连呼吸都慢了半拍。
[S1] 指尖在我锁骨上游移,
[S2] 仿佛试探一扇未曾开启的门。
不带情感方案下面这个是不带情感的基础节点,只要把audio和text这2个参数接入即可。
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
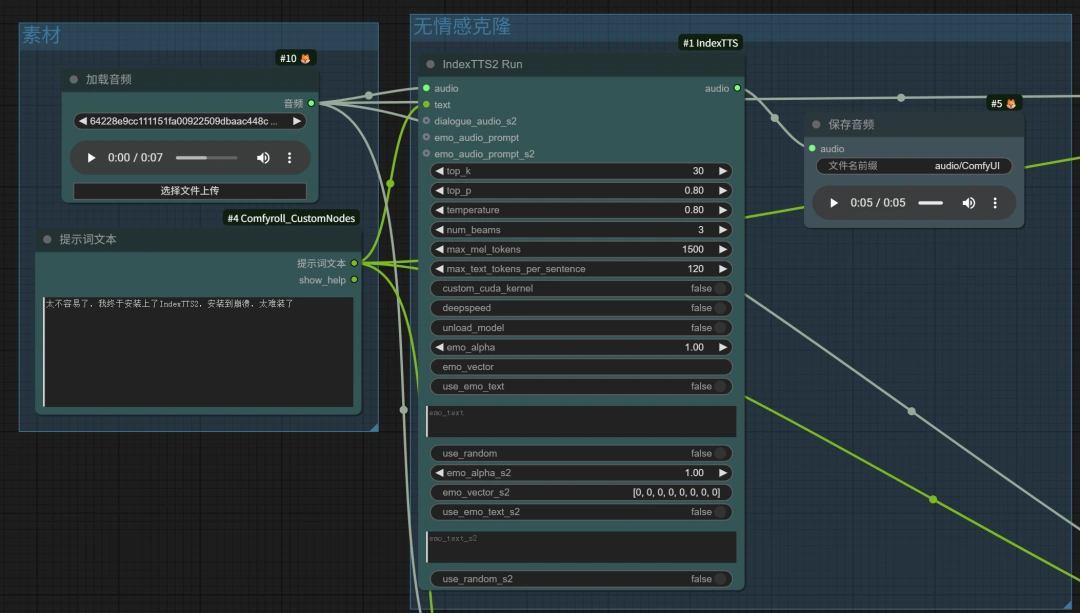
我的原音: 下面是不带任何方案跑的效果,这个是和我声音很像的 文本带情绪的方案
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
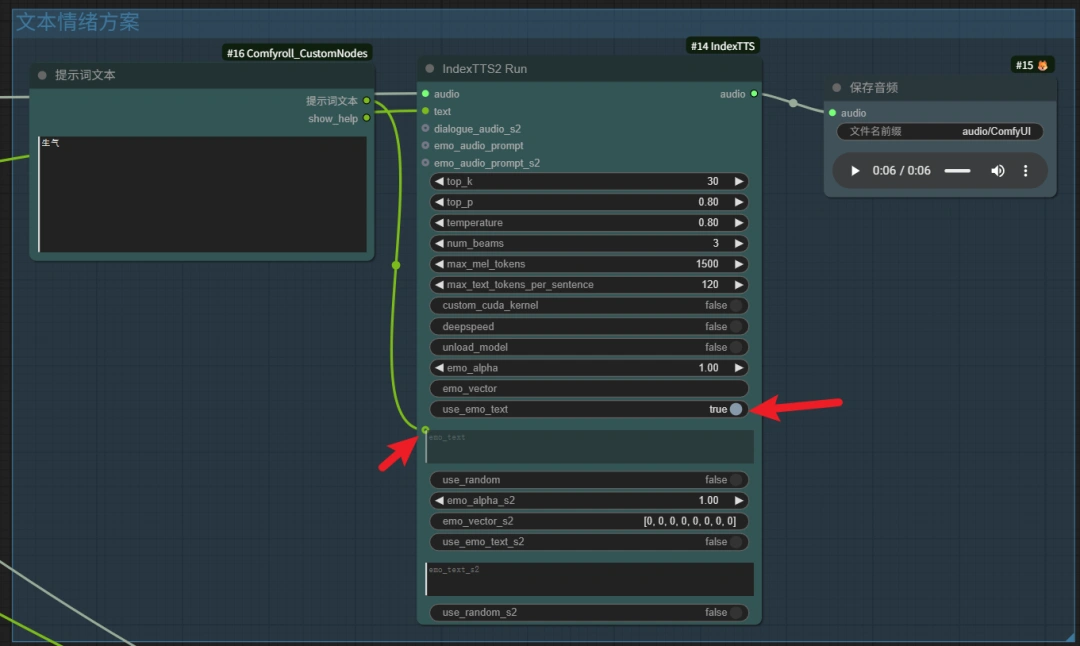
核心看我箭头,把use_emo_text开启,然后传入情绪文本即可,喜怒哀乐都行,我这里是生气。 生气的情绪是很到位了,但是感觉不像我的声音了,我这里权重是1
语音情绪参考方案
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
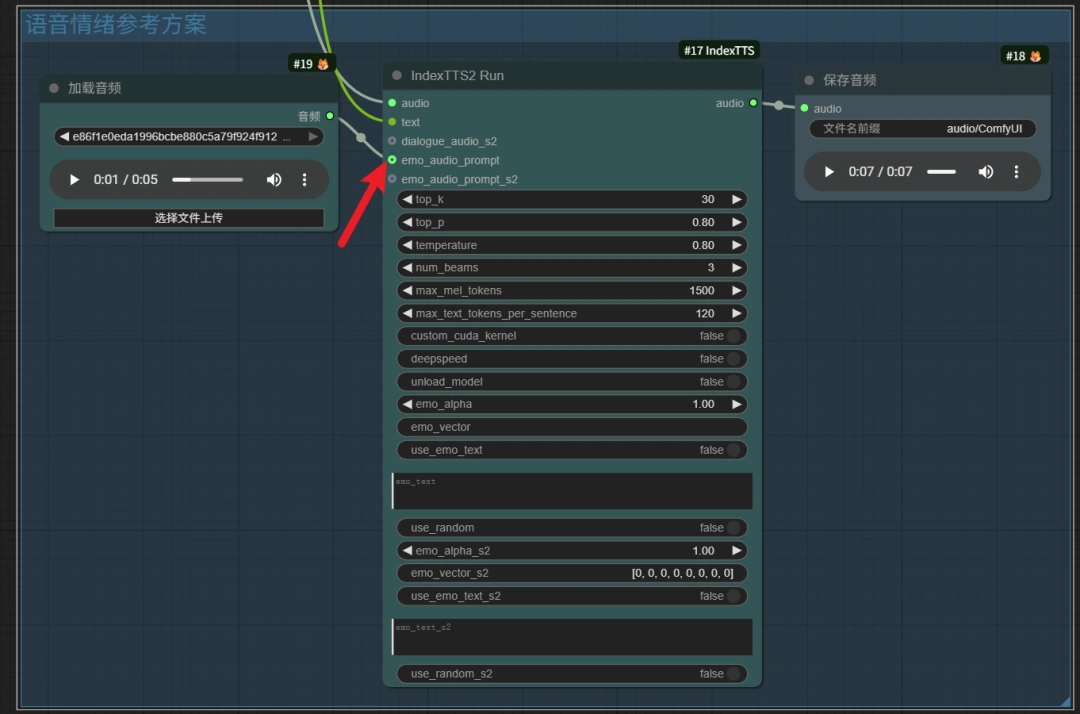
这种方案是传入一份沮丧的情绪语音作为参考 这个沮丧的感觉有,声音有点像,但是和卖家秀有点差距。
情感向量方案
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
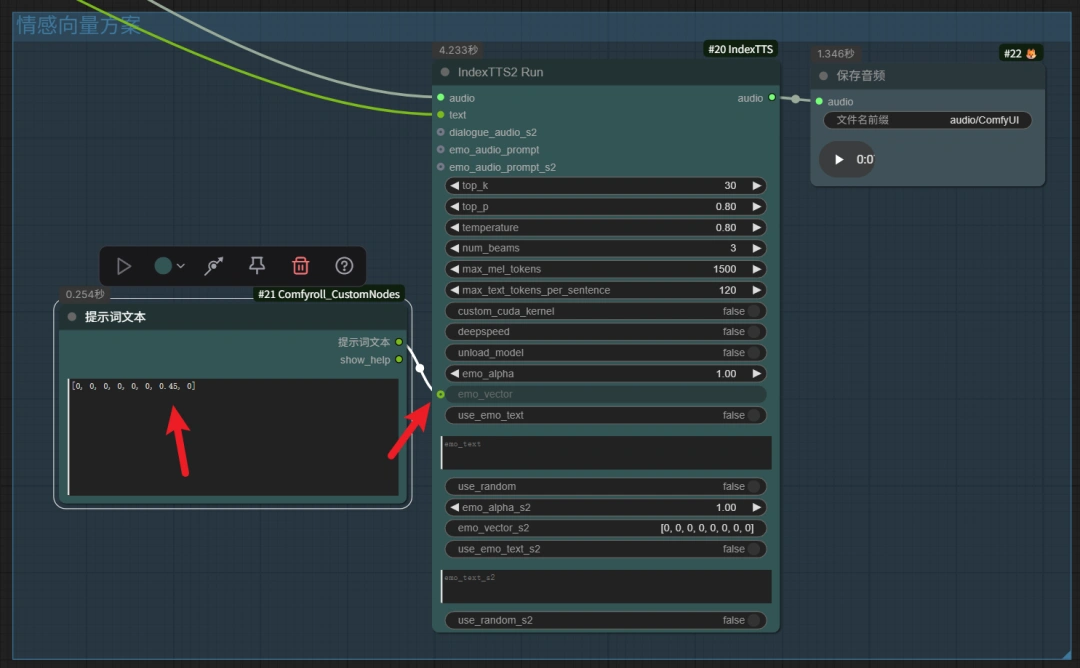
情感方案是这样。传入一个规则数组就行,规则参考上面列的参数说明。 我这里是惊喜这个情感设置了0.45
这个情绪也到位了, 但是音色好像也有点不像,权重0.45目前,可能还需要调低。
阶段总结好像除了默认的像,其他几种带情绪的方案都不是很像,情绪是有了,但是音色变化,不像我的声音了,真奇怪,这里需要调低强度再测试,大家也试试看。 3.2 双人版本
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
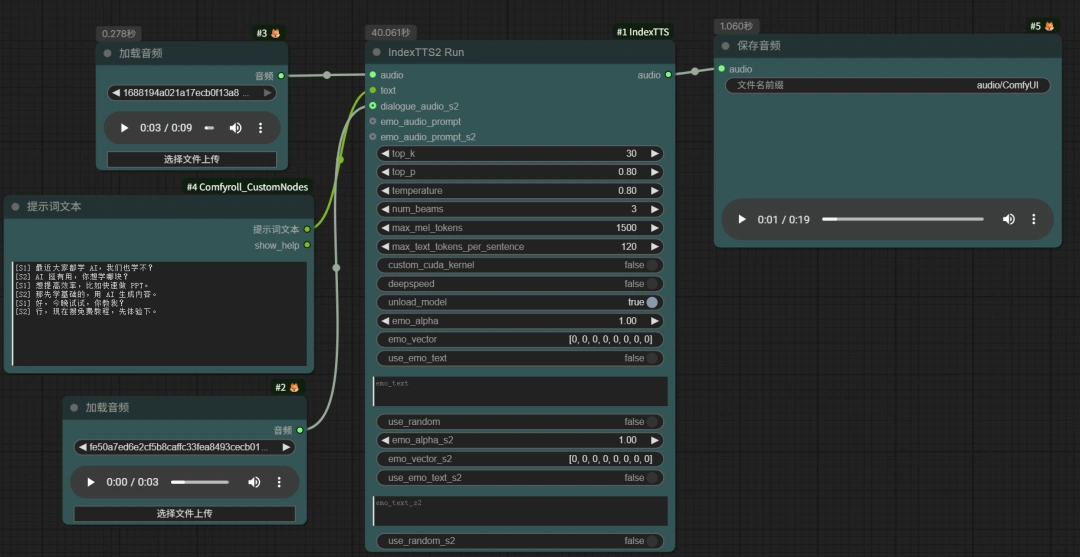
双人克隆声音的话,核心是主要书写格式,用[S1]和[S2]来区分开来即可,然后分别上传2个音频信息进来。 [S1] 最近大家都学 AI,我们也学不?
[S2] AI 挺有用,你想学哪块?
[S1] 想提高效率,比如快速做 PPT。
[S2] 那先学基础的,用 AI 生成内容。
[S1] 好,今晚试试,你教我?
[S2] 行,现在搜免费教程,先体验下。双人效果语音还是不错的,如果我不上传额外的情绪作为参考,就会默认用原声里面的情绪。 四、在线使用云端镜像
大家如果没有本地 ComfyUI 环境,或者本地显卡配置低于 16G 的,可以使用嘟嘟部署的仙宫云镜像,可直接加载使用。后续分享的工作流都会更像到镜像中,一周更新一次,方便大学学习。 目前整合了2个镜像,一个是Flux绘图用的,另外一个是针对视频模型的,之所以分开是一些模型兼容问题,分开比较好处理。 镜像名称:嘟嘟AI绘画趣味学
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
云平台镜像地址: https://www.xiangongyun.com/image/detail/d961a7dc-ade3-4bd5-a7c6-92ac49ff5e4b?r=37BCLY https://www.xiangongyun.com/image/detail/81716d29-4461-4b0b-ba4b-7b9b7dd569d3?r=37BCLY RH平台
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
主页更多精彩工作流可在线体验: https://www.runninghub.cn/user-c ... iteCode=kol01-rh024
IndexTTS2语音克隆:3种情感控制方式与ComfyUI安装教程
 五、总结 以上就是对IndexTTs2最新声音克隆技术介绍,这个有点搞不懂了,卖家秀里面效果是很好的,怎么这个ComfyUI插件里面体验起来效果有点落,大家先自己安装玩玩,后面看看作者是否有更新。 技术的迭代是飞快的,要关注最新的消息才不会掉队。 模型工作流获取本公众号对话框发送 250910 即可! 推荐阅读
Qwen Image Edit偏移问题有重大进展,大佬分享解决方案新思路Qwen-Image加速大升级!3G显存就能跑得飞起,Nunchaku V1正式发布!比IndexTTS强太多?ComfyUI最值得玩的开源语音克隆框架→MegaTTS3!【开源福利】音视频配音困境被打破!混元Foley让无声视频秒变震撼大片[ComfyUI]字节新框架USO来了!碾压IPAdapter,风格与主体双修的终极神

[ComfyUI]字节新框架USO来了!」碾压IPAdapter,风格与主体双修的终极神器
|

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)


 雷达卡


 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1