|
|
本帖最后由 疯狼GC 于 2026-9-15 18:18 编辑
【导语】
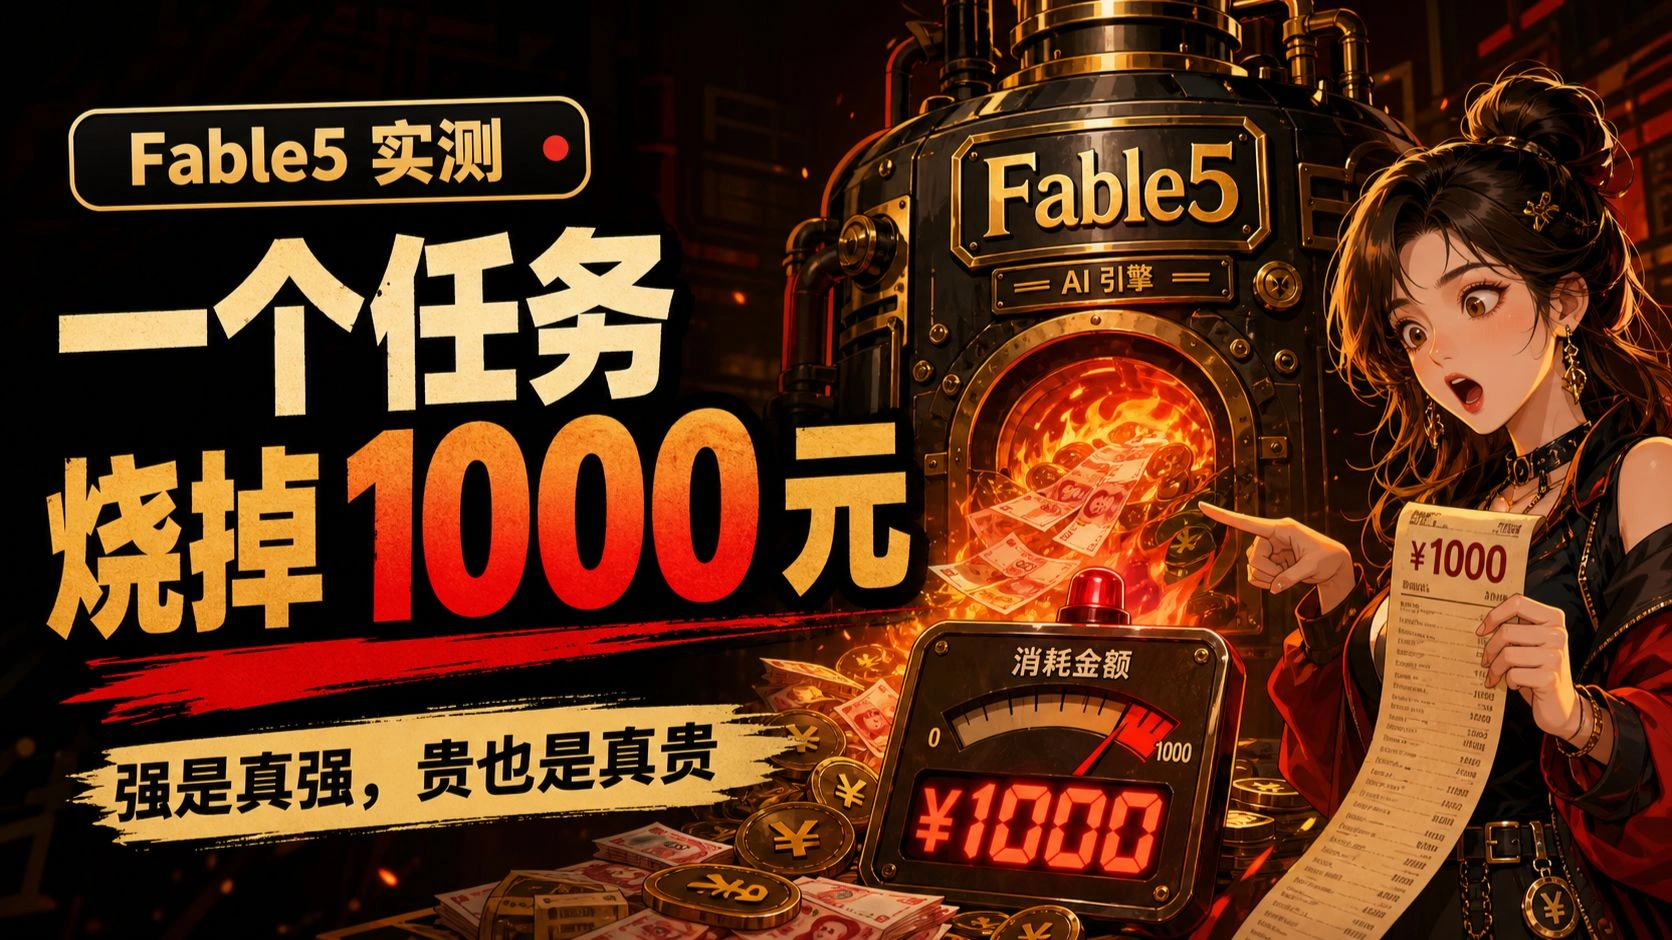
Anthropic 旗下 Claude 系列的「超级模型」Fable5(口播中亦称 Claude 超级模型)发布后,社区演示层出不穷:一句话做游戏、做操作系统、解难题,甚至只发 Hello 也能刷出夸张效果。本文整理创作者实测口播:能力确实强,但成本与节奏压力同样夸张——一次未完成的工程任务就烧近千元。
原视频:https://www.bilibili.com/video/BV1m5Eq6AEX9/
【现象:分数碾压与叙事压力】
口播提到公开榜单上相对第二名拉开约 20 分的优势,配合海量短视频案例,形成「不试 Fable5 就不配玩 AI」的营销叙事。创作者原本准备发布 Codex 官方案例库相关内容,因被 Fable5 对比「摁在地上摩擦」而搁置——侧面说明产品迭代与舆论节奏对创作者内容排期的冲击。
【实测场景:训练器 / 打标器工程】
作者当时在开发模型训练器与打标器,需要为 Ideogram 4 等新模型接入打标与相关格式支持。流程大致是:用 GPT 系模型出方案,再交给 Fable5 审核与执行。结果是单个任务尚未跑完就消耗约 500 元;跑到一半又不敢中途换模型,只能再充 500——一次版本相关更新的算力/API 支出接近 1000 元,而该版本更新本身未必能赚回同等收入。
口播还提到:Fable5 能发现子 Agent 调研错误、并协助规划子 Agent;任务跑完后,最新版打标器与训练器功能里有一部分正是这次付费调用的成果——「钱我来掏,东西给大家免费用」。
【对生态节奏的观察】
Codex 几乎日更仍难追上舆论焦点;用户每天第一件事下载更新,OpenAI 与 Anthropic 像在打热战。作者质疑:这种节奏是否必然有利于安全与质量?普通用户更新不过来也会累。
【旁注与免责】
口播末尾提醒:海鲜市场倒卖其训练器却把客服写成作者本人的行为与作者无关,作者未收款;并吐槽坚持只用某些本地廉价方案的用户「是真正的勇士」(调侃语境)。
【小结】
Fable5 类前沿代理模型在复杂工程任务上确实有「发现错误、拆分执行」的能力,但单价与未完成任务的沉没成本很高。对个人开发者:适合把高难度、一次性的架构/执行交给它,同时严格设预算与中断策略;不要被演示叙事绑架成「每件事都必须上旗舰模型」。
作者:天选嘉鲤敦赵图图
-
|
|
 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)



 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1