|
|
本帖最后由 疯狼GC 于 2026-9-15 18:19 编辑
【导语】
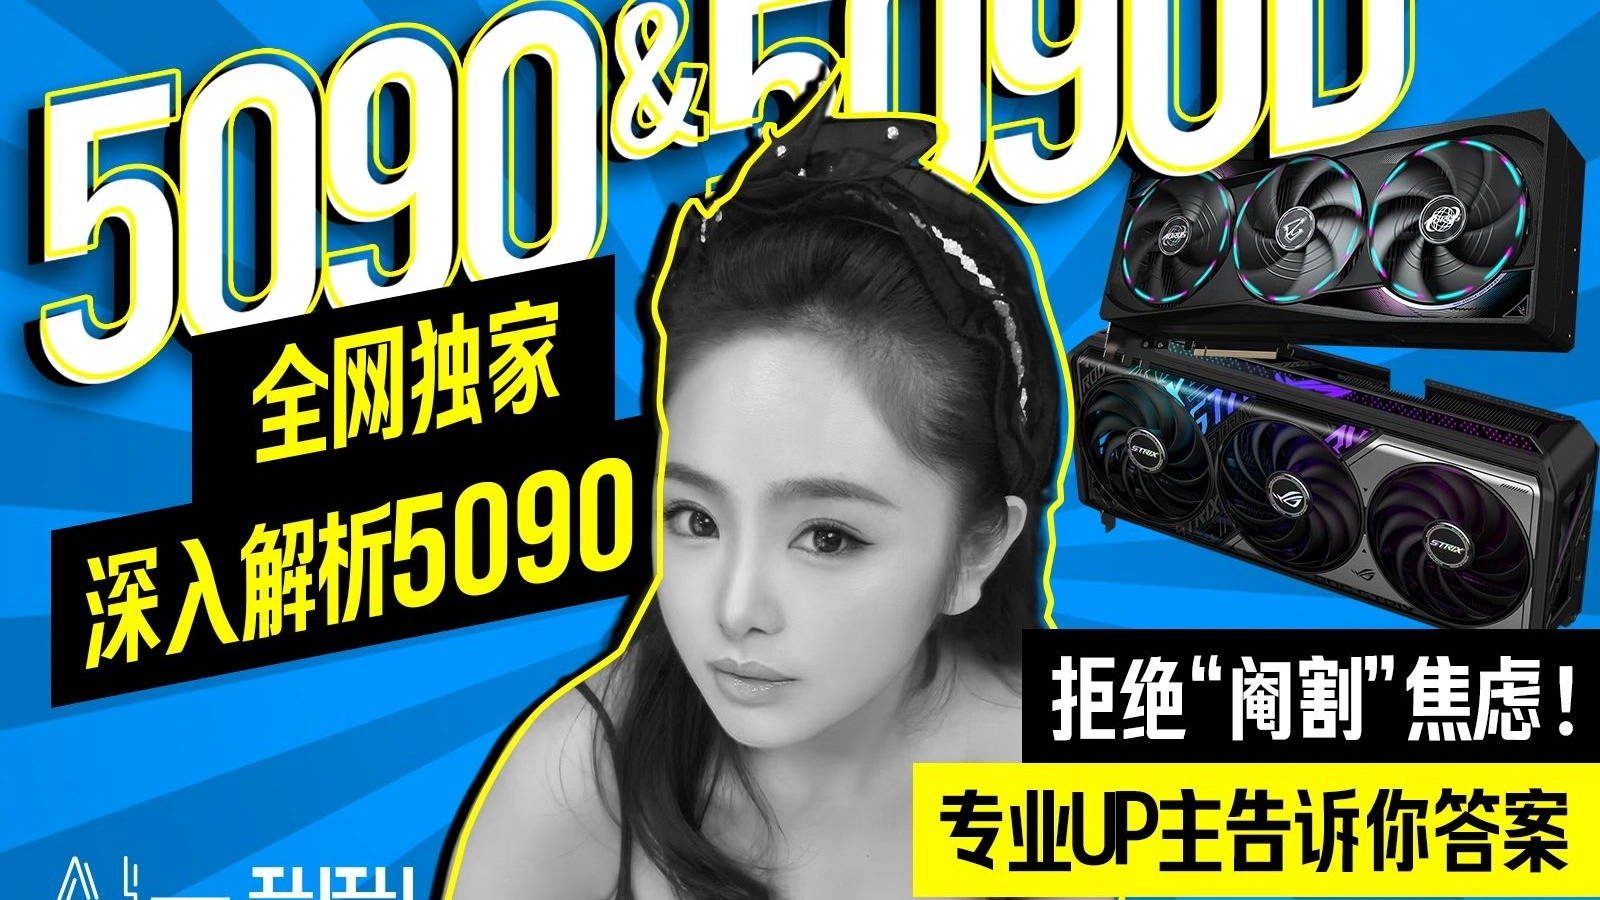
关于 RTX 5090 与 5090D「阉割」焦虑,社区多认为削减主要落在 FP4 等超低精度。本文整理创作者在完整版 5090(微星万图师)上、用底层 CUDA/WMMA 工具测得的张量核心算力结论,并建议与青龙等 UP 的 5090D 解析对照观看。
原视频:https://www.bilibili.com/video/BV1ohJnznEXt/
【规格回顾】
相较 4090,5090 在 CUDA 核心、张量核心与官方 AI TOPS 等指标上有显著提升。5090D 与 5090 在核心硬件规格上大体一致,官方标称 AI 算力存在差异——差异在不同精度路径上如何体现,是本次测试焦点。
【低精度生态现状】
业界对 FP8、FP4 等更感兴趣,新架构也加强硬件支持;但软件生态仍早期。口播援引 PyTorch 相关进展:FP4 作为 dtype 进入核心库初期仅支持有限算子(如类型转换、内部 API 的缩放矩阵乘),远未达到 FP16/BF16 的广泛覆盖。因此即便硬件能干 FP4,高级框架也未必方便调用——评估峰值往往要落到更底层的 CUDA/PTX 测试。
【测试方法】
- 工具:社区开源 M8PIC 类 CUDA 基准(直接调 WMMA / 低精度 PTX),比 PyTorch 更接近硬件理论峰值
- 作者优化:打印操作数与循环信息;每项多次运行取平均 TOPS,减少单次抖动;目标测试时间约 2 秒量级
- 环境:激活虚拟环境后跑优化版代码
【结合 5090D 侧疑点的对照思路】
青龙测试中常见困惑(口播归纳):FP32 略偏低、BF16/FP16 累加 FP32 偏高、部分 FP8→FP16 路径与预期不符、NVFP4 数值与「砍约 30%」叙事相关等。完整版 5090 对照的意义在于:区分「软件/测试误差」与「真正刀法」。
【关键结论(口播总结)】
1. 主流混合精度大体一致:当前常用的 TF32,以及 FP16/BF16 输入、FP32 累加等场景下,5090 与 5090D 理论表现基本一致;5090 自身相对白皮书也有小幅偏差(有的略低、有的略高),属正常波动范围讨论。
2. 刀法更集中在超低精度「高宣传 TOPS」路径:NVFP4 / MXFP4 等格式上,完整版相对 5090D 可到约 1.7 倍量级优势(口播归纳)。更值得注意的是:5090D 在纯 FP16 与部分 FP8 路径上也可能出现显著下降(需结合具体应用再确认)。
3. FP8 特性:FP8 输入配合 FP16 累加的性能,远高于配合 FP32 累加——更像硬件指令路径差异,而非简单「测反了」。带组缩放的 MXFP4/NVFP4 即使累加到 FP32,也可走更高通量专用路径(口播约 1460 量级 vs 常规 FP8→FP32 约 370 量级一类对比),说明厂商为宣传峰值开了高速通道,而「朴素低精度→FP32」通用路径通量有限。
4. 生态现实:5090 在 FP4 上硬件潜力很大,但框架全面支持仍需时间;峰值更多体现在底层基准,而非日常训练脚本一键吃满。
【选型建议】
- 要追未来超低精度红利、专业开发/推理极限:完整版 5090 更稳妥。
- 工作负载主要在当前主流混合精度、且预算敏感:5090D 在确认具体应用实测后仍有市场,不必被「阉割」叙事一刀切吓退。
作者:天选嘉鲤敦赵图图
-
|
|

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)


 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1