作者:
@T8star-Aix
视频中的错误示例:打八折被写成减8元,测试断言也跟着写错。
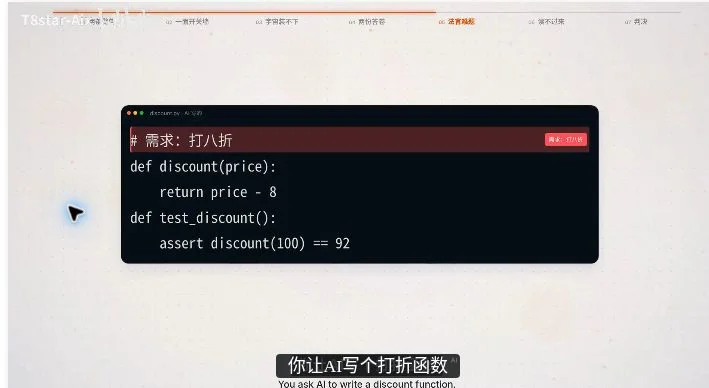
视频中的错误示例:打八折被写成减8元,测试断言也跟着写错。
AI 代码怎么审:先核题意和断言,再看测试通过
AI 给出代码、测试全部通过,是否就意味着任务完成?T8 这次借一次数学形式化验证的尝试,展示了一个更普遍的问题:程序可以准确地执行错误的要求,证明检查器也不能替人确认自然语言问题有没有被正确翻译。
本文只整理视频中可复用的检查顺序:查看实际构建结果,分清声明与证明,核对题意和测试断言,再让模型解释并暴露潜在漏洞。它不是数学论文的独立审查,也不认定原视频标题中的指数时间假说已被推翻;我们没有运行作者的工程。
一、先确认“通过”的究竟是哪一层
作者在画面中运行 Lean 项目的 lake build,终端显示构建成功;随后查看主要结果的公理依赖。视频中的输出属于作者这次运行的观察,不能直接替代对项目定义、依赖与目标命题的检查。
其中有一处容易误读:作者看到 Claims.lean 的 sorry 提示后,解释该文件是题面声明,而不是最终证明本体。仅凭声明文件里出现 sorry,不能立刻断言整个证明有漏洞;反过来,看到构建成功,也不能立即宣布数学结论成立。应继续核对最终被检查的命题是什么、证明实际依赖什么,以及它是否对应原始问题。
对于普通编程任务,同样要把几层结果分开:语法或构建通过、测试通过、满足用户要求,是不同的验收项目。前一项成功不会自动补齐后一项。
二、用折扣例子检查题意与断言是否一致
视频给出的错误示例很直观:需求是“打八折”,实现却把价格减去 8,测试又把 100 元的预期结果写成 92。
- # 视频中的错误示例:不要作为正确实现使用
- # 需求:打八折
- def discount(price):
- return price - 8
- def test_discount():
- assert discount(100) == 92
这样的测试会认可这个实现,但“减 8 元”不是“支付原价的 80%”。按题意,100 元打八折应得到 80 元。问题并不在测试框架,而在预期答案已经跟着错误实现走了。
因此,读 AI 生成的测试时,不要只问“它会不会通过”,还要逐项问:
1. 原始需求到底要求什么?先用自然语言写清楚。
2. 断言里的预期值从哪里来?是否独立依据需求确定,而不是照抄实现的输出?
3. 输入换成另一个简单例子,仍符合要求吗?
第三项是依据该反例整理的检查建议,不是声称作者额外执行过一组测试。涉及金额、舍入或边界输入时,还要先明确业务规则,不能把这个极简例子当完整支付系统代码。
三、让模型解释题面,再追问漏洞
作者接下来把形式化题面交给 Claude,请它用容易理解的方式说明,再追问可能存在的漏洞。画面中模型列出了多项疑点及其判断。
这种做法的价值,是把难读的定义转成便于继续检查的说明,并帮助提出问题;它不等于另一位专家已经完成独立审核。尤其当“生成答案”和“解释答案”都依赖模型时,模型的一句“没有问题”不能成为终点。
迁移到自己的任务时,可以先让模型说明输入、输出、限制条件以及它认为的成功标准,再将这份说明与原始需求逐条对照。发现不一致,就先修正题意或验收条件,而不是继续堆代码。这里给出的是操作思路,不是视频中的逐字提示词。
四、把验收顺序倒过来
视频收尾提出的顺序是:先用人话复述题目,再看测试断言,最后看结果是不是全绿。整理成实际检查表就是:
-
题意:实现或形式化命题是否仍在回答原来的问题?
-
断言:预期结果是否来自需求,而不是来自待验证的实现?
-
执行:构建、检查和测试是否真的完成,输出有没有被准确读取?
-
结论:只说已验证的部分;不能把模型自评、作者信心或局部通过写成整体正确。
在这次视频中,作者最终表达的是个人倾向与信心,并非展示了一份已完成的独立数学审查结论。对读者更有用的,是保留下这套区分“能跑”“测试通过”与“题目做对”的检查方法。
来源与资料
原作者简介列出的本期信源及 AI 制作工具资料:
作者资料页。这里只按原视频公开说明引用,不保证其内容、许可或下载可用性,本文不依赖其中未核实的材料来证明数学结论。
本文依据完整可用的官方中文 AI 可见字幕与关键演示画面整理,并按画面校正了个别识别错误;这不等于 ASR 或全部语音逐字转录。广告、互动口播与未经独立核实的数学新闻未作为教程事实展开。

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)

 雷达卡
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1