|
|
作者:@AIwood爱屋研究室
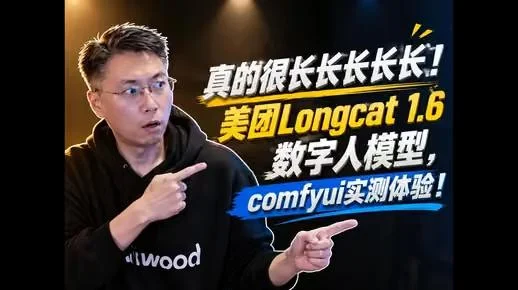
LongCat Avatar 1.6 面向人物口播与多人对话。AIwood 在 ComfyUI 中展示长口播生成与双人工作流,重点讲解角色提示词、独立音频和人物遮罩如何对应,而不是把两个说话人混在同一路输入里。
双人对话先分清两类提示词
整体正向提示词交代人数、左右位置、服装和镜头,例如两名女性坐在咖啡厅桌边,分别说明蓝色与黑色服装及固定中景。SAM3 的提示词则每次只描述一个角色,用服装、位置、发型或配饰区分目标,避免笼统描述两个人而同时框选。
音频对齐,再与遮罩逐一对应
每名说话人使用独立音频。演示先获取两段音频时长,通过补静音与音频拼接对齐时间轴,再分别编码。两个人物遮罩应先预览确认分离,再与相应音频编号连接,双人模式选择 two speakers。多人版最值得逐项检查的是:人数位置是否写清、角色是否被正确分割、音频是否对齐,以及遮罩与音频有没有接反。
长口播的收益与代价
作者介绍了循环与重叠片段的长视频生成思路,同时提醒这类相对固定机位的口播并不擅长大动态场景。分段推理耗时和资源占用较高,不能把长时长支持理解为快速生成;循环时也可能出现画面衔接或重叠问题。建议先用短音频验证角色、口型和接线,再扩展时长。
适合已有 ComfyUI 基础、需要制作单人讲解或固定机位多人对话的用户。具体节点连接与运行环境以原视频和作者提供的工作流为准。
作者提供的资源
【模型+工作流+素材网盘:https://pan.quark.cn/s/5584eb583fc3】
模型页面:Comfy-Org/LongCat-Video-Avatar
本文按授权视频的实际演示整理,建议观看原视频核对完整操作细节。 |
|

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)

 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1