作者:@AIwood爱屋研究室
Selflift-Avatar 与 Veda 演示封面
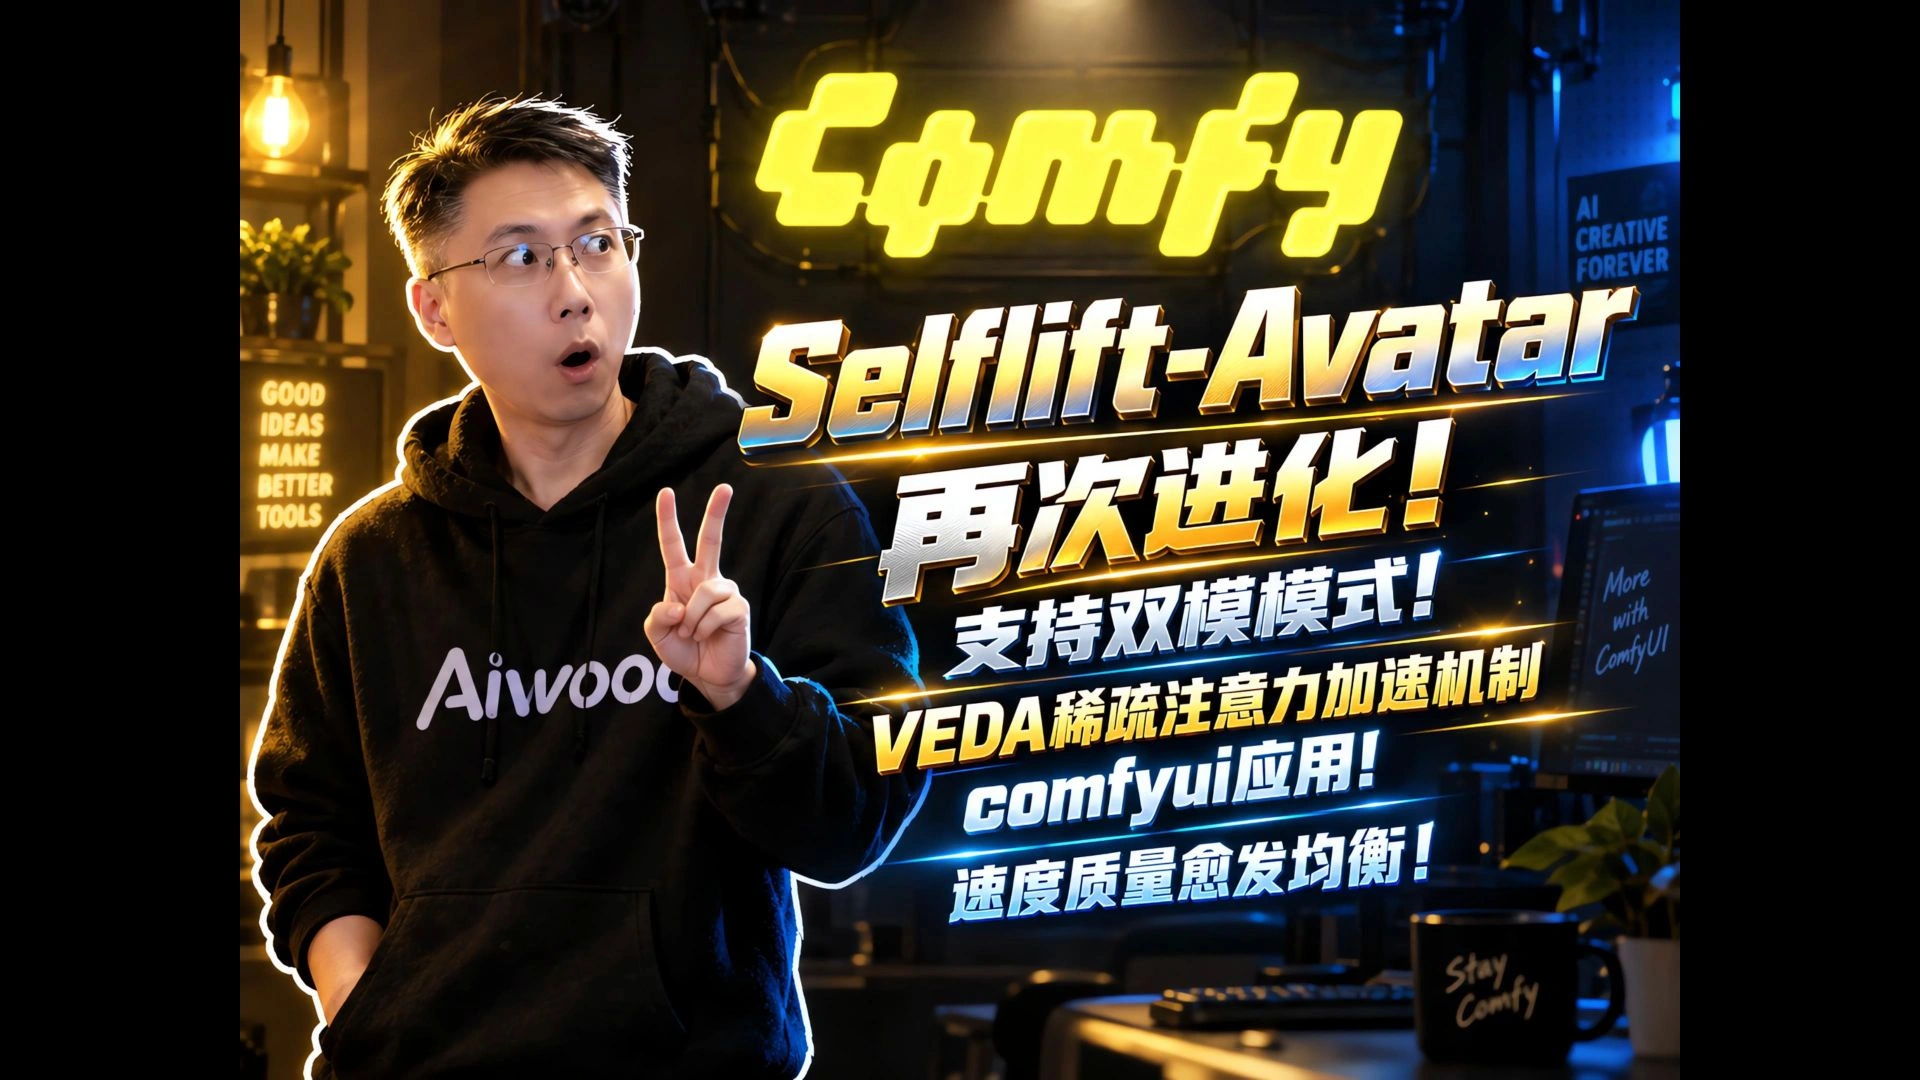
一句话导读:本期把 Selflift-Avatar 的两阶段模型接线和 Veda 稀疏注意力放在同一工作流中讨论,并用四组开关 Veda 的生成结果,展示采样速度与画面质量之间的取舍。
一、Selflift-Avatar 双模型怎么接
视频中的采样器提供 low_res_model 与 high_res_model,分别用于低、高分辨率阶段。只接低分辨率模型时,同一模型会继续完成高分辨率阶段。已有工作流升级后,应检查接口名称与连线。维护者当前说明指出,双模型能力此前已存在,本次 main 更新主要调整输入命名和布局;已有 v0.1.4-experimental 归档不包含该更新。模型装载仍由 ComfyUI 管理,不能据此保证不发生显存不足。
二、四组对比具体快了多少
视频中段先展示两类动作片段,后面的总结卡给出以下采样时间。这里保留视频使用的精度、图片模式和 LoRA 名称:
- 二采,2M 分辨率、10 秒,BF16 底模+图片 MAX+LIGHTX2V 0.1 LoRA:580→471 秒,采样耗时减少约 18.8%。
- 二采,2M 分辨率、10 秒,INT8C 底模+图片 MATCH+LIGHTX2V 0.1 LoRA:465→318 秒,减少约 31.6%。
- 单采,1M 分辨率、10 秒,INT8C+图片 MATCH+EMA600 LoRA,6 步:173→107 秒,减少约 38.2%。
- 同一单采配置,4 步:117→81 秒,减少约 30.8%。
以上百分比按“节省秒数÷原采样秒数”计算,与口头所说的速度提升比例不同。1M、2M 沿用画面标注,不换算为具体宽高。视频未完整披露硬件和预热等条件,这些结果仅代表作者这组前后对照,不是通用跑分。
三、Veda 的接入流程
Veda 通过小型预测模型选择需要计算的注意力区域。按视频流程及项目文档核对,先准备 ComfyUI 0.38.0 或更新版本,安装 Veda-on-ComfyUI 节点,将预测模型放入 ComfyUI/models/veda/,然后重启。把 Veda Sparse Attention (MiniMax H3) 接到模型与采样端之间;已有 LoRA 时放在 LoRA 加载后,并查看节点状态是否实际启用。
作者在简介补充,自己的编译环境需要与 ComfyUI 所用 Python 同版本的完整 Python 环境,并补齐 include、libs。该说明应结合所用安装方式处理,不要当成所有平台统一步骤。
四、质量与兼容性边界
作者指出,所测高动态场景的人物相似度有所下降,高分辨率案例出现闪烁;关闭加速 LoRA 后,单采和二采的 8 步结果也不相同。因此,选择配置时要同时比较动作、人物细节和闪烁,不能只看采样秒数。
简介关于“不能叠加其他稀疏注意力”的提醒需结合版本理解:当前项目文档按具体节点及连接顺序说明兼容性。调整现有工作流前,应查阅所安装版本的说明,并用相同种子做开关对照。
相关资源:
【Selflift-Avatar节点网盘:https://pan.quark.cn/s/d05d5bad8af9】
【Veda节点及模型网盘:https://pan.quark.cn/s/548777c0f901】
Selflift-Avatar 项目与版本说明
Veda-on-ComfyUI 安装与兼容性说明
Veda 预测模型
来源说明:本文根据 AIwood爱屋研究室的授权视频、画面对比标签及简介整理;版本、节点路径和兼容性另经当前项目文档核对。时间数据来自作者演示,未作独立性能复测。 |

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)

 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1