作者:@AIwood爱屋研究室
Hunyuan Image3.0与Selflift整合包演示原封面
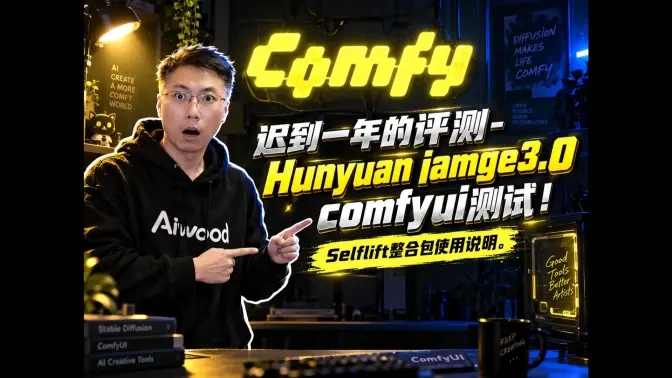
这期视频分为两部分:先测试第三方ComfyUI节点中的Hunyuan Image3.0文生图与图像编辑,再说明Selflift/H3整合包的模型放置和视频工作流设置。两部分使用不同模型与工作流,下载和配置时应分别核对,不能把后半段的视频参数套到前半段图像生成中。
Hunyuan Image3.0:先分清模型与工作流
作者介绍节点可通过克隆项目或下载压缩包安装,并区分蒸馏与非蒸馏模型。视频采用的蒸馏设置为8步,普通版本为50步;节点同时提供文生图和编辑工作流,使用时应选择与模型对应的流程。
提示词处理方面,作者认为配套重写模型在自己的测试中较慢,于是在文生图中使用Qwen Image 2.1 PE相关模型配合TextGenerate节点扩写提示词;图像编辑则直接使用自然语言指令。这是作者采用的替代做法,不是所有任务都必须增加扩写步骤。
演示画面使用1024×1024分辨率,并展示HunyuanImage-3.0 Spectrum节点的enabled开关。作者称在所示8步设置下,开关加速的耗时差异不到10秒;他也提醒更高分辨率会增加显存压力和等待时间。视频对W4A8显存需求的说法属于作者经验,本文不将其当作已复测的硬件门槛。
效果比较中,作者认为该模型在部分姿势迁移样例上仍有价值,同时认为综合文生图与编辑能力不及他常用的较新模型。这是有限样例下的主观观察,不能推定为统一测评结论。
Selflift/H3整合包:先放模型,再加载工作流
后半段介绍的整合包包含ComfyUI环境、模型、工作流及图文和纯文字使用说明。作者要求把模型部分按现有文件夹结构复制到ComfyUI的models目录,再加载对应工作流。画面可见vae、text_encoders、diffusion_models、loras、llm等分类目录;不要把所有模型文件混放到同一层。
包内展示了四条工作流,覆盖长视频拼接、Selflift数字人、参考生视频和常规文生视频。长视频示例先拼接两段,再说明可按同样结构继续延续;这不代表段间衔接必然无缝,仍需检查生成结果。
按显存与动态调整视频设置
作者在Selflift相关流程中给出控速LoRA的4至8范围建议,并演示显存节省选项与高分辨率分块。无法判断分块设置时,他建议先选择自动;显存仍不足,可降低分辨率,并按需要调整时长。具体开关应对照包内说明和当前节点版本,不照搬其他工作流的同名参数。
步数也按用途区分:作者对动态较低的数字人建议总步数6、低分步数4或5;对动态要求较高的参考生视频,示例建议总步数8、低分步数6。这些是视频中的起始设置,画质、运动和显存占用仍需结合素材试跑确认。
作者提供的资源
【Selflift整合包网盘地址:https://pan.quark.cn/s/a81af865371c】
【Hunyuan Image3.0蒸馏模型网盘地址:https://pan.quark.cn/s/f5f55e6e9589】
ComfyUI版蒸馏模型
ComfyUI版普通模型
Hunyuan Image3.0第三方ComfyUI节点
本文依据原视频可见官方AI字幕、已观察画面及作者简介整理,未独立安装或复测,也未逐项核验下载内容与许可。请以对应版本说明为准,使用有授权的图像、声音和人物素材,不冒充他人。
|

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)

 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1