|
|
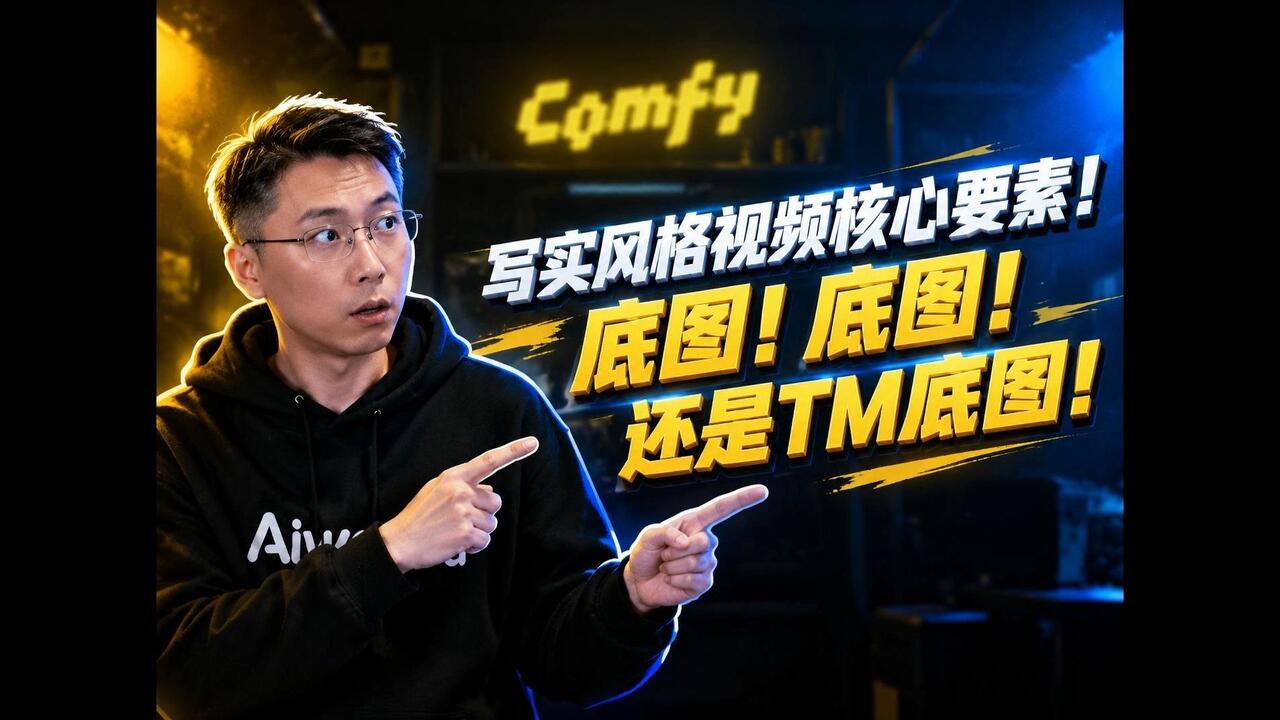
Moss 写实底图到 H3 视频:纪实提示词与参考图用法
想让 AI 视频更像现场拍到的画面,可以先检查送入视频模型的底图,而不是一开始就寻找新的采样参数。AIwood 这次演示的路线,是用 Moss 融合模型生成写实图片,再把选好的图片送进作者使用的 MiniMax H3 相关工作流。重点不在重新搭建一套节点,而在底图的摄影感、提示词的表达,以及参考图进入视频任务的方式。
本文面向已经有对应 ComfyUI 工作流的读者,整理作者展示和说明的操作思路,不补写视频没有交代的模型安装、节点版本和完整连线参数。作者对写实程度及效果优劣的判断属于其示例经验,不是本文独立完成的模型横评。
一、先把底图做成“有人在现场拍摄”的照片
作者把底图的方向概括为抓拍、纪实和现场感,并认为它对最终视频的真实感影响很大。他所说的“完成了80%”是强调底图重要性的经验说法,不是量化实验结果。
这次使用的是此前介绍的 Moss 模型融合工作流,作者明确说选择了“均衡模式”。这只是本次演示的选择,不能由此推出它在所有人物、场景和风格中都最优,也不能把模式名称直接换算成未展示的融合强度数值。
对于已有该工作流的读者,可按这个顺序准备底图:
1. 先说清画面里有什么:人物或主体、所在环境,以及正在发生的活动。
2. 再补充摄影意图,例如随手拍、纪实摄影、现场感,而不只堆叠“高清”“真实”等抽象评价。
3. 将简短需求交给提示词扩写环节,检查扩写结果是否仍符合原来的场景目标。
4. 生成图片后先判断构图和视觉风格是否合适,再决定是否送去生成视频。
作者不是先手写一篇很长的提示词,而是把大概需求交给大模型扩写。画面中可见的例子,把“随手拍、纪实摄影作品”与90年代深夜网吧、人物活动和符合年代环境的中文元素放在一起。这里真正值得借鉴的是“场景内容+拍摄方式+时代环境”的组织方式,而不是把某一整段提示词当成通用公式。
二、“闪光灯直闪”是风格选择,不是真实感开关
作者特别强调了“闪光灯直闪拍摄”这一表达,并用宿舍电脑前的人物图和网吧图作说明。在他的比较中,直闪效果更容易让画面呈现有人近距离拍摄的现场感;另一个示例则显得更疏离或更像摆拍。
可将这一思路理解为:提示词不仅描述被拍摄的对象,也描述摄影者如何参与画面。直闪是其中一种视觉选择,并不等于任何场景加入这几个字都会更自然。
实际检查底图时,可以问自己三个问题:
- 人物、道具和环境是否共同指向同一个生活场景?
- 希望的抓拍或纪实感觉是否真的出现在结果里,而不仅存在于提示词中?
- 光线效果是否符合这张图的用途,还是只让画面变得更亮、更突兀?
这些是整理后的检查方法,不是作者提供的可量化评分标准。本期也没有展示固定种子和完整控制变量,因此不能把两张示例的全部差异都认定为由一个词单独造成。
三、把选好的底图接入已有视频工作流
视频部分仍沿用作者已经分享的双采 Self-Lift 工作流,并没有在本期另做一套新的完整工作流。其简介给出了对应资源链接,但本文未独立验证资源下载、运行条件或当前版本。
本次做法的区别在于:作者说明自己选用了“reference to video”,即参考图生成视频的节点,同时在提示词中明确表达图生视频任务,让这张参考图承担首帧的作用。
这与“看到参考图节点,就认为所有工作流都能严格锁住第一帧”不是一回事。本文只能确认作者在该演示中的说明,不能补造其他节点需要怎样连接、怎样设置强度,或保证它在不同版本中行为相同。
按本期内容,可将视频准备过程整理为:
1. 选定一张已经符合目标风格的底图,不把底图问题全部留给视频模型补救。
2. 在作者使用的参考生视频路径中提供这张图片,并在任务描述中说明希望按图生视频方式使用它。
3. 交代希望生成的内容,并确定视频时长;如果片段需要人物讲话,再明确台词。
4. 使用提示词扩写环节整理需求,然后检查扩写内容是否改变了原意。
5. 查看输出时,重点比较开头与后续画面的色调衔接,以及底图的视觉风格是否得到延续。
本期没有给出可直接套用的完整参数表;上述顺序帮助读者理解已有工作流的使用目的,并不是从零安装教程。
四、重点观察首帧到后续画面的衔接
作者指出,他在直接图生视频时观察到过首帧与后续帧之间轻微的色调转换。本次改用参考生视频路径、同时让参考图作为首帧的方式,在他的示例中衔接更好。
这应当保留为作者对特定工作流与样例的观察,而不是 H3 所有模式的统一结论。它也不意味着已经排除了底图、提示词或其他设置造成的影响。
因此,复现时应先确认自己是否真的遇到了相同问题。如果已有输出衔接正常,没有必要仅因为视频使用了另一种路径,就认定原来的流程一定错误。反过来,如果开头仍出现色调跳变,也不能凭本篇文章断定是哪一个未展示参数导致的。
作者还提到沿用已有的 H3 提示词扩写方案,明确时长与台词即可组织示例片段。本期并没有给出一套新的秘密提示词、专用 LoRA 或全新工作流。不要把“视频看起来更真实”自动归因于并未展示的额外模型或参数。
五、这次能学到什么,哪些还不能保证
这条制作路线可以概括为:先确定纪实摄影的视觉目标,用 Moss 生成并筛选底图,再在已有 H3 工作流里明确参考图用途、时长与台词,最后检查画面衔接。
文章提供的是源视频支持的操作思路和检查重点,不保证同一提示词每次都产生相同结果,也不保证人物身份、动作和光线在视频中始终完全一致。模型性能、资源可用性、工作流兼容性和商业许可均未由本文独立验证。
来源与资源
来源作者:AIwood爱屋研究室。源发布时间:2026-10-27 12:09:31(Asia/Shanghai)。
来源视频:https://www.bilibili.com/video/BV1F5xK6EEpg/
以下为作者在视频简介及置顶评论回复提供的资源,已去除邀请参数;只保留为来源入口,不保证可用性、价格或许可:
- Moss 模型融合工作流:https://www.runninghub.cn/post/2114890474770227202/
- 黑科技加速双采 Self-Lift 工作流:https://www.runninghub.cn/post/2097505105535913985/
- 图片、视频素材及工作流:https://pan.quark.cn/s/75625a0e548f
- H3Selflift 整合包(作者置顶评论中的回复提供):https://pan.quark.cn/s/a345c62bd438
本文依据00:00–06:21的完整可用官方可见字幕及所见画面整理,包含同BV回放补漏,字幕中“mos/mouse”等按标题及上下文整理为 Moss,“地图/守针”等分别按上下文整理为底图、首帧。字幕空白不代表没有语音;该来源级别不等于 ASR 或完整原音频转写。示例片段台词、互动引导与结尾争论不作教程步骤转载。
AIwood爱屋研究室 |
|

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)

 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1