作者:@AIwood爱屋研究室
AIwood 原视频封面:RelayVSR 视频放大教程
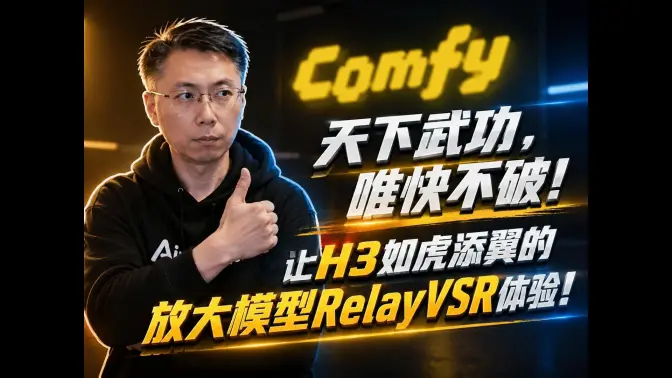
封面沿用原视频封面,图中的宣传用语为原作者表述。
导读
RelayVSR 在这期演示中承担的是视频放大与细节增强。AIwood 用 ComfyUI 展示了两倍、四倍两套模型的切换方法,以及 VSR Decode 节点中 detail 参数对画面观感的影响。本文按实际操作顺序整理,重点是模型配对、视频接线和效果取舍。
先记住两个边界:作者展示的一步采样不等于整个视频在一步内完成;画面变锐也不等于原有瑕疵被修复。视频中的高动态片段就保留了明显的像素化问题。
一、准备:更新 ComfyUI,模型和 VAE 成对选择
作者在视频约 00:28 开始介绍准备工作:先更新到包含 RelayVSR 支持的 ComfyUI 版本,再准备对应模型。这里需要区分扩散主模型和 VAE,两者都要有。
视频展示了两倍与四倍两套选择。选择两倍主模型时,加载对应的两倍 VAE;改成四倍时,主模型和 VAE 两处一起切换。不要只改其中一个加载器,也不要把“换倍率”理解为随便修改输出分辨率。
原简介提供了模型、工作流和对比素材入口,见文末。本文没有核验下载目标中的文件、完整依赖和安装目录,不能据此认定资源包已能直接运行。复现前应先核对自己的 ComfyUI 是否能识别视频展示的 RelayVSRConditioning 和 VSR Decode 节点。
二、工作流:保留原片图像、音频和帧率
视频约 01:03–01:44 展示的处理链可以按下面顺序检查:
1. 载入待放大的视频,通过“获取视频元素”取出图像帧、音频和帧率。输入图像帧参与后续放大,音频和帧率则保留给最后的视频合成。
2. 加载相同倍率的扩散主模型与 VAE。画面中的主模型加载器显示为 UNet 加载器,另有独立的“加载 VAE”节点。
3. 将主模型与输入图像送入 RelayVSRConditioning,并按演示工作流把条件及 latent 接入采样器。作者强调这里使用一步采样;画面中的采样步数也是 1。
4. 采样结果交给 VSR Decode,同时保留对应 VAE 和原始图像帧的输入连接。detail 就在这个解码节点内调整,不在模型加载器内。
5. 把 VSR Decode 输出的图像接到“创建视频”,接回输入视频的帧率和音频,再连接“保存视频”。这样整理连线,能看清哪些数据经过放大,哪些数据来自原片。
如果已经导入作者工作流,复现时可以先核对这五个环节,不必把所有节点重新搭一遍。视频讲的是这条具体放大流程,不能据此推断任意旧版节点或任意视频规格都兼容。
三、detail 怎么选:先理解作者的三个对比
作者从约 02:11 开始解释 detail。按他的直观说法,可以把它理解为增强结果与原片观感之间的融合程度;这是帮助调节的解释,本文不把它当成未经核验的算法公式。
- 两倍放大,detail 1.0:作者用 1080P 原片作对比,指出发丝等细节明显变锐。同时,他也认为这一组偏硬、偏锐,可能带来不够自然的感觉。1.0 是视频所述默认值,不代表对所有素材都最好。
- 两倍放大,detail 0.5:作者认为这一组相对柔和,发丝没有上一组那么生硬。他也明确把这种取舍归为个人喜好。
- 四倍放大,detail 0.7:作者在另一组对比里展示了这一组合,并对人物质感给予较积极的评价;同时提醒放大后的文件很大。这里既改变了倍率,也改变了 detail,不能当成只改一个参数的严格对照实验。
如果想复现这期对比,可先保留同一小段原片,比较两倍的 1.0 和 0.5,再按需求尝试四倍的 0.7。这是按视频案例整理的试验顺序,不是通用最优参数。观察时除了看发丝是否清楚,也要看肤质、衣物和边缘是否出现不符合原片的变化。
四、效果边界:增强细节也可能改变细节
作者在约 03:12 特别提到,这个过程会对画面进行重绘。后面的四倍样例中,他观察到面部噪点减少、皮肤更光滑,发丝与衣物细节也有变化。因此,教程中的“更清楚”应结合样片理解,不能直接写成无损还原。
约 04:50 开始,作者换成了高动态片段,检查原有像素化是否能被修复。他的结论是效果并不理想:该有的问题仍然存在,只是部分观感变柔和。若素材的主要问题就是高速运动时的像素化,不应预期仅靠这一步放大就能解决。
五、速度要分开看:采样、解码、保存
作者在约 05:27–05:52 报告:把一段 768P 视频放大两倍,采样约需 8 秒多;四倍放大的采样约需 30 多秒。这是作者对自己测试的描述,不是本文独立复测,也不是完整导出耗时。
他紧接着指出,放大后的文件较大,解码和保存反而可能比采样花更多时间。现有来源没有给出足以复核这些数字的完整显卡、显存、输入帧数及端到端测试条件,因此不能据此保证其他机器也有同样速度,或推算具体硬件门槛。
实际评估时,应把采样完成和视频文件保存完成分开计时,同时关注输出体积。只看采样节点的秒数,容易低估整个任务的等待时间。
六、复现前的简短检查
- ComfyUI 能识别视频中的 RelayVSR 专用节点。
- 主模型与 VAE 都已选择,且两者放大倍率一致。
- 采样步数按本期演示设置为 1。
- VSR Decode 保留所需输入,detail 按自己的原片对比选择。
- 创建视频时已接回原片帧率与音频。
- 检查结果是否过锐、肤质是否被改动,以及动态像素化是否仍然存在。
- 把解码、保存时间和输出体积纳入评估,不将作者的采样用时当作整条流程的速度承诺。
原简介资源入口
以下只保留原视频简介中的地址。目标页面、文件内容、可用性和使用许可均未核验,请自行确认后使用。
【模型+工作流+对比素材网盘:https://pan.quark.cn/s/69a2164ccef7】
【模型 Hugging Face 页面:https://huggingface.co/Comfy-Org/RelayVSR/tree/main】
本文依据原视频完整可用的官方可见字幕及对应画面原创整理,不是逐字语音转录。参数取舍、画质评价与耗时均保留原作者演示的范围;具体连线和动态对比建议结合原视频查看。
|

 简体中文
 English(英语)
 日本語(日语)
 Deutsch(德语)
 Русский язык(俄语)
 بالعربية(阿拉伯语)
 Türkçe(土耳其语)
 Português(葡萄牙语)
 ภาษาไทย(泰国语)
 한어(朝鲜语/韩语)
 Français(法语)

 雷达卡

 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

 粤ICP备2026002389号-1